Posted in حلول الشبكات, شبكات الشركات on نوفمبر 05, 2026
مراقبة الشبكات والتنبيهات للشركات

كيف تبني نظام مراقبة وتنبيهات للشبكات في الشركات؟
كثير من أعطال الشبكات لا تبدأ بانقطاع كامل يجعل الجميع يعرف أن هناك مشكلة. قد يبدأ العطل بارتفاع تدريجي في استهلاك أحد الروابط، أو فقد متقطع للحزم، أو منفذ في سويتش يتغير بين Up وDown، أو نقطة وصول لاسلكية تستقبل عددًا غير معتاد من المستخدمين، أو جهاز شبكة ترتفع موارده تدريجيًا، أو خدمة تتوقف لدقائق ثم تعود. إذا لم تكن هناك منظومة مراقبة، فقد يكون أول تنبيه يصل لفريق التقنية هو مكالمة من موظف يقول: “الإنترنت بطيء” أو “النظام لا يعمل”.
Network Monitoring يحول إدارة الشبكة من رد فعل بعد ظهور المشكلة إلى عملية مستمرة تعتمد على الرؤية والقياس والتنبيه. بدل انتظار المستخدم ليكتشف الخلل، تتم متابعة حالة الراوترات والسويتشات ونقاط الوصول والروابط والواجهات والخدمات، ثم مقارنة السلوك الحالي بالمستوى الطبيعي، وإرسال تنبيه عندما تظهر حالة تحتاج إلى تدخل.
لكن مجرد تركيب برنامج مراقبة لا يعني أن الشركة أصبحت تراقب شبكتها بطريقة صحيحة. إذا كانت كل مشكلة تولد عشرات الإشعارات، أو إذا لم تكن الأجهزة المهمة موجودة في المنصة، أو إذا كانت التنبيهات بلا أولوية، أو إذا وصلت الرسالة إلى بريد لا يراجعه أحد، فإن لوحة المراقبة قد تبدو ممتازة بصريًا بينما الاستجابة الفعلية للأعطال لا تتحسن.
هذا الدليل يشرح كيفية بناء نظام Network Monitoring للشركات بطريقة عملية تشمل جرد الأجهزة، مراقبة الحالة والأداء والروابط، التنبيهات، السجلات، Syslog وSNMP، لوحات المراقبة، تحديد الأولويات، تقليل الإنذارات المزعجة، توثيق الحوادث، والاستجابة للأعطال. الموضوع مستقل عن ازدواج الإنترنت، النسخ الاحتياطي والتعافي، الألياف، الكابلات المهيكلة، التحكم بالدخول، وتصميم Wi-Fi التي تمت تغطيتها سابقًا.
 اتصال مباشر
 واتساب
نظام المراقبة الجيد لا يسأل فقط: هل الجهاز يعمل أم لا؟ بل يراقب الحالة، الأداء، السعة، الروابط، الواجهات، الموارد، الأخطاء، السجلات، والتغيرات غير الطبيعية. قد يكون السويتش Online لكن أحد منافذه الحرجة يعاني أخطاء متكررة أو أن الرابط وصل إلى مستوى استخدام يؤثر على التطبيقات.
ابدأ بجرد الأصول: ما الأجهزة الموجودة؟ ما عنوان كل جهاز؟ أين موقعه؟ ما دوره؟ وما درجة تأثير تعطله على العمل؟ لا يمكن بناء تنبيهات صحيحة لشبكة لا يوجد لها Inventory واضح.
لا تجعل كل حدث Alert عاجلًا. صنّف التنبيهات إلى مستويات مثل Critical وHigh وWarning وInformational، واربط كل مستوى بمسار استجابة واضح. تعطل الرابط الرئيسي يختلف عن ارتفاع بسيط ومؤقت في استهلاك أحد المنافذ.
الهدف النهائي ليس لوحة جميلة على شاشة NOC؛ الهدف هو تقليل زمن اكتشاف المشكلة، تحديد مكانها بسرعة، معرفة ما الذي تأثر، توجيهها للشخص المناسب، ثم الاحتفاظ بسجل يساعد على منع تكرارها.
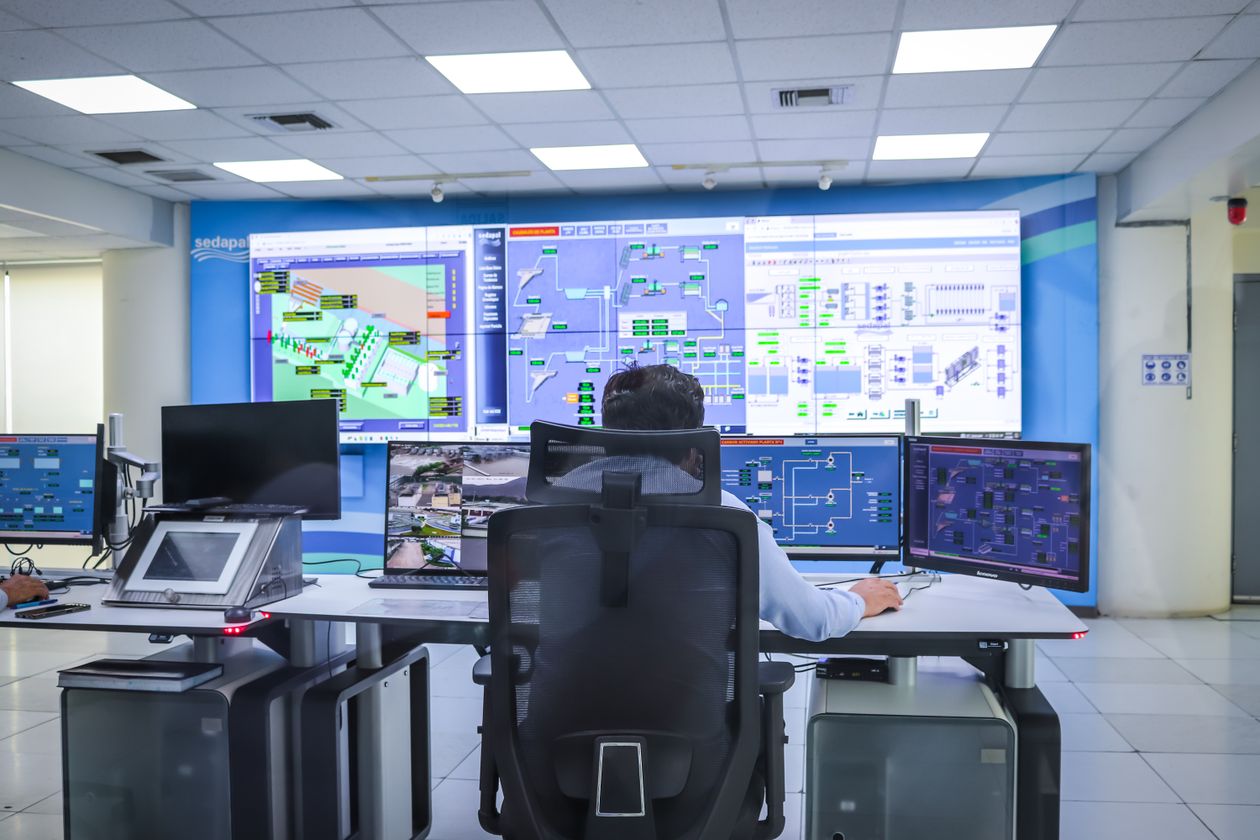
ما المقصود بمراقبة الشبكات Network Monitoring؟
هي عملية مستمرة لجمع معلومات من أجهزة الشبكة وروابطها وخدماتها وعرضها بطريقة تساعد الفريق على معرفة الحالة الحالية، اكتشاف المشكلات، تحليل الأداء، ومتابعة الاتجاهات بمرور الوقت.
قد تشمل المراقبة الراوترات، السويتشات، الجدران النارية، نقاط الوصول، وحدات التحكم، الخوادم المرتبطة بالبنية الشبكية، وصلات الإنترنت، روابط الفروع، وبعض الخدمات التي تعتمد عليها الشبكة.
لا تقتصر المراقبة على Ping. Ping يجيب عن سؤال محدود: هل يمكن الوصول إلى عنوان معين؟ لكنه لا يخبرك بالضرورة بحالة الواجهات، استخدام النطاق، أخطاء المنافذ، CPU، الذاكرة، أو السجلات.
لهذا فإن النظام الفعال يجمع أكثر من نوع من البيانات حتى يعطي صورة تشغيلية متكاملة.
لماذا تحتاج الشركة إلى المراقبة حتى لو كانت الشبكة “تعمل”؟
لأن وجود الشبكة Online لا يعني أن أداءها صحي.
قد تكون وصلة تعمل لكنها تقترب من التشبع يوميًا في وقت محدد. وقد يكون هناك منفذ يعمل لكنه يولد Errors. وقد تكون نقطة وصول متصلة لكنها تستقبل عددًا غير متوازن من المستخدمين.
بدون بيانات تاريخية، يصبح تشخيص المشكلات مبنيًا على التخمين. المستخدم يقول إن البطء حدث الساعة 11 صباحًا، لكن عند وصول الفني الساعة 1 ظهرًا يكون كل شيء طبيعيًا.
نظام المراقبة يسمح للفريق بالعودة إلى البيانات ورؤية ما حدث وقت المشكلة.
لماذا يجب أن يبدأ نظام المراقبة بجرد الأجهزة؟
إذا لم تعرف ما الموجود في الشبكة فلن تعرف ما الذي يجب مراقبته.
أنشئ Inventory يحتوي على اسم الجهاز، النوع، الموديل، عنوان الإدارة، الموقع، الدور، الجهاز الأعلى أو الرابط الذي يعتمد عليه، والجهة المسؤولة عنه.
ميّز بين جهاز أساسي في الشبكة وبين جهاز طرفي محدود التأثير.
عند إضافة أو إزالة جهاز يجب تحديث الجرد ومنصة المراقبة معًا حتى لا تبقى أجهزة منسية أو تنبيهات لأجهزة لم تعد موجودة.
كيف تصنف أهمية الأجهزة قبل بناء التنبيهات؟
ليس كل جهاز له نفس الأثر.
تعطل Core Switch قد يؤثر على قسم أو مبنى كامل، بينما تعطل Access Point واحدة قد يؤثر على مساحة محدودة.
أنشئ تصنيفًا مثل Critical وHigh وMedium وLow بناءً على أثر الجهاز على العمل، وليس على سعره فقط.
هذا التصنيف سيحدد لاحقًا مستوى التنبيه، سرعة التصعيد، ومن يجب أن يستقبل الإشعار.
| التصنيف | مثال | أثر العطل | طريقة المتابعة |
|---|---|---|---|
| Critical | Core Router / Core Switch | تعطل واسع | تنبيه وتصعيد فوري |
| High | سويتش قسم أو رابط فرع | توقف مجموعة مستخدمين | تنبيه سريع |
| Medium | Access Point فردية | تأثير محدود | متابعة تشغيلية |
| Low | حدث معلوماتي | لا يوجد توقف مباشر | سجل وتقارير |
ما العناصر التي يجب مراقبتها داخل الشبكة؟
ابدأ بحالة الجهاز: Up أو Down.
ثم راقب الواجهات الرئيسية، استهلاك الروابط، الأخطاء، التأخير، فقد الحزم، CPU، الذاكرة، درجات الحرارة عندما يوفر الجهاز هذه البيانات، وعدد العملاء أو الجلسات إذا كانت ذات أهمية تشغيلية.
لا تراقب كل Counter متاح لمجرد أن الأداة تستطيع قراءته. اختر مؤشرات تساعدك على اتخاذ قرار.
كثرة المقاييس دون هدف تجعل لوحة المراقبة مزدحمة وتزيد صعوبة اكتشاف الإشارة المهمة وسط البيانات.
كيف تراقب توفر الأجهزة بطريقة أدق من Ping واحد؟
Ping مفيد لمعرفة إمكانية الوصول الأساسية، لكنه يجب ألا يكون المؤشر الوحيد.
يمكن أن يكون الجهاز Reachable بينما خدمة الإدارة أو إحدى واجهاته المهمة متوقفة.
راقب الخدمة التي تمثل دور الجهاز الحقيقي. إذا كان الجهاز Router، راقب الواجهات المهمة وحالة المسارات أو الروابط المناسبة لنطاق المشروع.
ولا تجعل فشل Probe واحد يؤدي مباشرة إلى إعلان عطل شامل؛ استخدم منطقًا يقلل التنبيهات الناتجة عن فقد لحظي.
كيف تراقب منافذ السويتشات والواجهات المهمة؟
لا تحتاج كل منفذ مستخدم عادي إلى Alert فوري عند Down، لأن الموظف قد يفصل جهازه بشكل طبيعي.
ركز التنبيهات على Uplinks، منافذ الخوادم، نقاط الوصول، الكاميرات المهمة، روابط الفروع، والواجهات التي يعتمد عليها جزء من الشبكة.
راقب كذلك Errors وDiscards والتغيرات المتكررة في حالة المنفذ.
منفذ Up لكنه يولد أخطاء متزايدة قد يكون أكثر أهمية من منفذ Down معروف أنه غير مستخدم.
كيف تراقب استهلاك الروابط دون اعتبار كل ارتفاع مشكلة؟
راقب Inbound وOutbound لكل رابط مهم وارسم الاستخدام بمرور الوقت.
الاستخدام المرتفع لفترة قصيرة قد يكون طبيعيًا أثناء نسخ ملف أو تحديث نظام. أما الاقتراب المتكرر من السعة في أوقات العمل فقد يشير إلى حاجة للتحليل أو التخطيط للسعة.
لا تستخدم Threshold واحدًا لكل الروابط. وصلة فرع صغير تختلف عن Uplink لمئات المستخدمين.
الأهم هو معرفة السلوك الطبيعي لكل رابط ثم اكتشاف الانحراف عنه.
ماذا تخبرك مراقبة Latency وPacket Loss؟
بعض المشكلات لا تسبب Down كاملًا، بل تجعل التطبيقات بطيئة أو متقطعة.
مراقبة Latency تساعد على معرفة تغير زمن الوصول، بينما Packet Loss يكشف فقدًا قد يؤثر على المكالمات والتطبيقات والخدمات الحساسة.
قارن القراءات بالسلوك المعتاد للرابط بدل اعتماد رقم واحد لكل البيئات.
إذا ظهر ارتفاع في التأخير في وقت محدد كل يوم، قارنه مع استخدام النطاق والأحداث الأخرى لنفس الفترة.
لماذا تراقب CPU والذاكرة وموارد أجهزة الشبكة؟
بعض الأعطال تبدأ قبل توقف الجهاز بزمن.
ارتفاع CPU لفترة مستمرة قد يؤثر على الاستجابة أو يشير إلى حمل غير معتاد. واستهلاك الذاكرة المتزايد بمرور الوقت قد يكون مؤشرًا يستحق التحقيق.
لا تتعامل مع قراءة مرتفعة لحظية كحادث دائمًا. راقب مدة الارتفاع وعلاقته بالأحداث الأخرى.
الهدف هو اكتشاف اتجاه غير طبيعي، لا مطاردة كل قفزة قصيرة.
ما دور SNMP في Network Monitoring؟
SNMP من الوسائل الشائعة لجمع معلومات تشغيلية من أجهزة الشبكة مثل حالة الواجهات، الاستخدام، الأخطاء، الموارد، وأرقام أخرى يوفرها الجهاز.
منصة المراقبة تستعلم عن هذه القيم دوريًا وتحوّلها إلى رسوم وبيانات وتنبيهات.
عند استخدام SNMP يجب تأمين إعدادات الإدارة وعدم ترك الوصول مفتوحًا بلا حاجة.
كما يجب اختيار المقاييس المطلوبة بدل سحب آلاف العناصر التي لا يستخدمها أحد.
ما الفرق بين مراقبة المقاييس وSyslog؟
المقياس يخبرك مثلًا أن CPU وصل إلى قيمة معينة أو أن منفذًا أصبح Down.
Syslog قد يخبرك بما حدث داخل الجهاز: تغير واجهة، محاولة دخول، تعديل إعداد، إعادة تشغيل، خطأ بروتوكول، أو حدث آخر يسجله النظام.
لهذا فإن Metrics وLogs يكملان بعضهما.
عند ظهور مشكلة، الرسم البياني يوضح متى بدأت، والسجل قد يساعد في فهم الحدث الذي حدث في الوقت نفسه.
لماذا تجمع السجلات في منصة مركزية بدل تركها داخل كل جهاز؟
لأن الرجوع لكل جهاز على حدة أثناء العطل يستهلك وقتًا وقد تصبح بعض السجلات القديمة غير متاحة إذا كانت مساحة الجهاز محدودة.
التجميع المركزي يسهل البحث حسب الوقت والجهاز ونوع الحدث ويساعد على ربط الأحداث بين عدة مصادر.
إذا حدثت مشكلة الساعة 10:14، يمكن للفريق البحث في سجلات عدة أجهزة حول نفس الدقيقة بدل تسجيل الدخول إلى كل جهاز يدويًا.
يجب تحديد سياسة احتفاظ مناسبة لحاجة الشركة وحجم البيانات بدل حفظ كل شيء بلا إدارة أو حذف السجلات بسرعة دون سبب.
ما هو Baseline ولماذا هو أهم من رقم ثابت؟
Baseline هو صورة للسلوك الطبيعي للشبكة خلال أوقات وظروف مختلفة.
قد يكون استهلاك رابط بنسبة مرتفعة طبيعيًا لمدة عشر دقائق في نهاية الدوام بسبب عملية معروفة، بينما يكون نفس السلوك في منتصف الليل غير معتاد.
اجمع بيانات كافية لفهم النمط الأسبوعي وأوقات الذروة قبل بناء قواعد صارمة.
عندما تعرف الطبيعي، يصبح اكتشاف الشاذ أسهل.
كيف تحدد Thresholds دون توليد تنبيه مع كل تغير؟
استخدم حدودًا مرتبطة بسياق الجهاز والخدمة.
يمكن أن يعتمد التنبيه على قيمة معينة مع مدة زمنية، وليس على تجاوز لحظي.
مثال: ارتفاع استخدام مورد لثوانٍ قد لا يحتاج Alert، بينما استمرار الارتفاع لعدة دقائق قد يستحق المتابعة.
راجع الحدود بعد تشغيل النظام؛ إذا كانت تولد الكثير من الإنذارات غير المفيدة عدّلها بناءً على البيانات الفعلية.
| العنصر | ماذا تراقب؟ | التنبيه المفيد | التنبيه المزعج |
|---|---|---|---|
| رابط رئيسي | الحالة والاستخدام | Down أو ضغط مستمر | ارتفاع ثوانٍ قليلة |
| Uplink | Errors / Utilization | تزايد غير طبيعي | كل تغير بسيط |
| CPU | القيمة والمدة | ارتفاع مستمر | قفزة لحظية |
| Access Point | الحالة والعملاء | Down أو اختلال واضح | تغير عميل واحد |
كيف تصنف التنبيهات إلى Critical وHigh وWarning؟
اربط مستوى التنبيه بأثر المشكلة على الخدمة.
Critical يعني عادة أن هناك توقفًا أو خطرًا مباشرًا يؤثر على وظيفة أساسية.
High قد يعني تدهورًا واضحًا أو تعطل جزء مهم مع استمرار بعض الخدمة.
Warning يعني أن هناك مؤشرًا يستحق المتابعة قبل أن يتحول إلى عطل.
Informational يمكن استخدامه للأحداث التي تحتاج تسجيلًا لكن لا تستدعي تدخلًا فوريًا.
كيف تمنع عشرات التنبيهات عندما يتعطل جهاز واحد أعلى الشبكة؟
افهم الاعتماديات.
إذا تعطل سويتش رئيسي وتوجد خلفه عشر نقاط وصول وأجهزة أخرى، لا تحتاج بالضرورة إلى ثلاثين Alert مستقلًا وكأن ثلاثين مشكلة مختلفة حدثت.
اربط Parent وChild أو Dependencies عندما تدعم منصة المراقبة ذلك.
الهدف هو أن يعرف الفني أن السبب المرجح هو الجهاز الأعلى، بينما الأعطال الأخرى نتائج مترتبة عليه.
ما هو Alert Fatigue ولماذا يجعل نظام المراقبة أقل فائدة؟
يحدث عندما يستقبل الفريق عددًا كبيرًا من التنبيهات لدرجة أن التنبيه الحقيقي يضيع بينها.
إذا وصل عشرات الإشعارات يوميًا عن أحداث لا تحتاج إجراءً، يبدأ الفريق تدريجيًا بتجاهل التنبيهات.
راجع أكثر القواعد إصدارًا للإنذارات واسأل: هل يحتاج هذا الحدث إلى شخص يتصرف الآن؟
إن لم يكن، قد يكون مكانه Dashboard أو تقريرًا دوريًا بدل Push Notification عاجل.
ماذا يجب أن تعرض Dashboard الرئيسية؟
يجب أن تساعد المشاهد على معرفة حالة الشبكة خلال ثوانٍ.
اعرض عدد الأجهزة الحرجة المتوقفة، الروابط الرئيسية، أهم التنبيهات المفتوحة، المواقع أو الفروع المتأثرة، وأي مؤشرات تشغيلية مهمة.
لا تعرض خمسين رسمًا صغيرًا لا يمكن قراءتها من مسافة.
أنشئ لوحات مختلفة حسب الجمهور: لوحة تشغيل للفنيين، وربما لوحة مبسطة للإدارة تعرض التوفر والاتجاهات والحوادث الرئيسية.
كيف تستخدم شاشة NOC دون أن تتحول إلى ديكور؟
الشاشة الكبيرة ليست هدفًا بحد ذاتها.
اجعلها تعرض حالة واضحة يمكن قراءتها من بعيد: المواقع المتأثرة، التنبيهات الحرجة، الروابط الرئيسية، وربما Timeline للحوادث الحالية.
التفاصيل الدقيقة يجب أن تبقى داخل النظام عند فتح الجهاز أو الحادث، لا على الشاشة الرئيسية.
إذا كان الفريق يعمل عن بعد، نفس المنطق ينطبق على لوحة الويب؛ المهم وضوح الأولوية وليس حجم الشاشة.
إلى أين يجب إرسال التنبيهات؟
اختر القناة حسب خطورة الحدث.
الأحداث الحرجة قد تحتاج قناة سريعة ومباشرة بالإضافة إلى نظام التذاكر أو البريد.
الأحداث الأقل أهمية يمكن تجميعها في تقارير أو قنوات تشغيلية.
لا ترسل كل شيء لكل الموظفين. حدد الفريق المسؤول عن الشبكات، ومن يستقبل التنبيه خارج الدوام إذا كانت الخدمة تتطلب ذلك.
كيف تبني مسار Escalation واضحًا؟
التنبيه بدون مسؤولية واضحة ليس عملية تشغيل.
حدد من يستقبل أولًا، ومتى ينتقل الحادث إلى مستوى أعلى إذا لم تتم معالجته، ومن يتواصل مع مزود الخدمة إذا تبين أن المشكلة خارجية.
مثال: الفني الأول يتحقق من الحالة، ثم ينتقل الحادث لمهندس الشبكات إذا كانت المشكلة معقدة، ثم لمزود الاتصال أو المورد حسب السبب.
الهدف أن لا تبقى المشكلة معلقة لأن الجميع ظن أن شخصًا آخر يتابعها.
ماذا يجب أن يحدث فور وصول تنبيه حقيقي؟
أولًا تحقق أن التنبيه حقيقي وليس مجرد فقد لحظي أو صيانة معلنة.
ثانيًا حدد نطاق التأثير: جهاز واحد، قسم، فرع، أم عدة خدمات؟
ثالثًا راجع الأحداث التي حدثت في نفس الوقت: تغير إعدادات، Down على Uplink، ارتفاع استهلاك، أو سجل خطأ.
رابعًا حدد الإجراء الأكثر أمانًا وملاءمة لإعادة الخدمة أو احتواء المشكلة.
وبعد استقرار الوضع، سجل السبب والإجراء لمنع تكرار نفس التحقيق من الصفر لاحقًا.
كيف تنفذ Triage سريعًا للعطل؟
اسأل: ما الذي توقف؟ ومن المتأثر؟ وما آخر شيء تغير؟
افحص الجهاز الأعلى في مسار الاتصال قبل النزول إلى كل جهاز طرفي.
قارن الوقت الحالي بالبيانات التاريخية.
راجع السجلات والأحداث في نفس الدقيقة.
لا تبدأ بإعادة تشغيل الأجهزة عشوائيًا؛ قد تمحو أدلة مهمة أو تسبب انقطاعًا أكبر.
| المرحلة | السؤال | المعلومة المطلوبة | النتيجة |
|---|---|---|---|
| التحقق | هل العطل حقيقي؟ | عدة Checks | تأكيد الحادث |
| النطاق | من المتأثر؟ | Topology / Dependencies | تحديد الأولوية |
| التحليل | ماذا تغير؟ | Logs / Metrics / Changes | فرضية السبب |
| الاستجابة | ما الإجراء؟ | Runbook / خبرة فنية | استعادة الخدمة |
كيف توثق العطل بعد الانتهاء منه؟
سجل وقت بداية المشكلة، وقت اكتشافها، الأجهزة أو الخدمات المتأثرة، أول Alert، سبب العطل إن تم تحديده، الإجراءات، ووقت عودة الخدمة.
سجّل كذلك ما إذا كان التنبيه وصل في الوقت المناسب أم لا.
إذا اكتُشفت المشكلة من المستخدم قبل نظام المراقبة، فهذا مؤشر مهم على وجود Gap في المنظومة.
التوثيق يساعد على تحسين التنبيهات وRunbooks وقرارات التوسعة لاحقًا.
ما التقارير التي تستفيد منها الإدارة بدل إرسال تفاصيل تقنية كثيرة؟
الإدارة تحتاج معرفة التوفر، عدد الحوادث المؤثرة، المواقع الأكثر تعرضًا للمشكلات، الاتجاهات، والموارد التي تقترب من حدودها التشغيلية.
لا ترسل مئات أسطر Syslog إلى مدير غير تقني.
حوّل البيانات إلى أسئلة تجارية: كم مرة تأثر الفرع؟ هل المشكلة تتكرر؟ هل هناك رابط يحتاج توسعة؟ هل زمن اكتشاف الأعطال يتحسن؟
التقرير الجيد يساعد على اتخاذ قرار، لا مجرد إثبات أن منصة المراقبة تجمع بيانات.
كيف تساعد Network Monitoring في التخطيط للسعة؟
البيانات التاريخية تكشف الاتجاهات.
إذا كان استخدام Uplink يرتفع تدريجيًا شهرًا بعد شهر، يمكن التخطيط قبل الوصول إلى مستوى يسبب اختناقًا.
ويمكن مقارنة فترات الذروة بين الفروع أو معرفة الأجهزة التي بدأت مواردها تصبح محدودة.
بهذه الطريقة تتحول المراقبة من أداة أعطال فقط إلى أداة تخطيط للبنية التحتية.
كيف تساعد المراقبة بعد تغيير إعداد أو تنفيذ صيانة؟
قبل التغيير، سجل Baseline.
بعد التغيير، راقب المؤشرات نفسها وقارنها.
إذا تم نقل خدمة أو تعديل مسار أو تحديث إعداد، راقب الاستخدام والأخطاء وLatency والحوادث في الفترة التالية.
ربط Change Management بالـMonitoring يجعل تقييم التغيير مبنيًا على بيانات بدل القول: “يبدو أنه يعمل”.
أين تتقاطع Network Monitoring مع المراقبة الأمنية؟
توجد منطقة مشتركة بين التشغيل والأمن، لكن لا يجب الخلط بينهما بالكامل.
نظام Network Monitoring يركز غالبًا على التوفر والأداء والحالة، بينما SIEM ومنصات الأمن تجمع وتحلل أحداثًا أمنية على نطاق أوسع.
مع ذلك، أحداث مثل تغييرات غير متوقعة، محاولات دخول، إعادة تشغيل غير مخطط، أو تغيرات سلوكية قد تكون مهمة لكلا الفريقين.
في البيئات الأكبر يمكن ربط البيانات أو إرسال السجلات إلى منصة أمنية مركزية حسب حاجة الشركة.
كيف تبدأ مشروع Network Monitoring دون تعقيد زائد؟
ابدأ بالأجهزة الحرجة والروابط الرئيسية.
ابنِ Inventory نظيفًا.
أضف Availability وInterfaces واستخدام الروابط والموارد الأساسية.
بعدها أضف Syslog والسجلات التي تحتاجها.
شغّل النظام فترة لفهم Baseline، ثم عدّل Thresholds.
بعدها أنشئ Dashboard وEscalation وRunbook للحوادث الأكثر احتمالًا.
التوسع التدريجي أفضل من إضافة مئات الأجهزة وآلاف التنبيهات في يوم واحد ثم مواجهة نظام لا يستطيع أحد إدارته.
هل تعتمد شبكتك اليوم على بلاغ المستخدم لاكتشاف المشكلة؟ يمكن بناء مراقبة مركزية للأجهزة والروابط والتنبيهات والسجلات مع مسار واضح للاستجابة للأعطال.
ما أكثر الأخطاء الشائعة في أنظمة مراقبة الشبكات؟
الخطأ الأول تركيب منصة المراقبة قبل عمل Inventory واضح للأجهزة.
الخطأ الثاني مراقبة Ping فقط واعتباره كافيًا.
الخطأ الثالث إعطاء كل جهاز نفس مستوى الأهمية.
الخطأ الرابع إضافة كل Interface في النظام كتنبيه Critical.
الخطأ الخامس إطلاق Alert عند كل تغير قصير دون مدة تأكيد.
الخطأ السادس استخدام Threshold واحد لكل الأجهزة والروابط.
الخطأ السابع عدم بناء Baseline للسلوك الطبيعي.
الخطأ الثامن إرسال كل التنبيهات لكل أعضاء الفريق.
الخطأ التاسع عدم تحديد من يملك كل Alert.
الخطأ العاشر عدم وجود Escalation عند تجاهل التنبيه.
الخطأ الحادي عشر توليد تنبيهات للأجهزة التابعة عندما يكون الجهاز الأب متوقفًا.
الخطأ الثاني عشر عدم تجميع Syslog مركزيًا.
الخطأ الثالث عشر جمع سجلات كثيرة دون إمكانية بحث أو تحليل مفيدة.
الخطأ الرابع عشر ترك بيانات اعتماد الإدارة أو بروتوكولات المراقبة دون حماية مناسبة.
الخطأ الخامس عشر تصميم Dashboard مليئة بالرسوم التي لا تقود لقرار.
الخطأ السادس عشر عدم تسجيل الصيانة المخطط لها مما يولد تنبيهات كاذبة.
الخطأ السابع عشر إعادة تشغيل الجهاز مباشرة قبل مراجعة السجلات والسبب.
الخطأ الثامن عشر إغلاق الحادث بعد عودة الخدمة دون توثيق السبب.
الخطأ التاسع عشر عدم مراجعة أكثر Alerts تكرارًا لتحسين القواعد.
الخطأ العشرون اعتبار Network Monitoring مشروعًا ينتهي بعد التركيب بدل عملية تشغيل مستمرة.
ما قائمة الفحص الكاملة لبناء نظام مراقبة شبكات؟
Inventory:
☐ جميع الأجهزة المهمة مسجلة.
☐ عنوان الإدارة معروف.
☐ الموقع معروف.
☐ الدور معروف.
☐ المسؤول عن الجهاز معروف.
الأهمية:
☐ الأجهزة Critical محددة.
☐ الأجهزة High محددة.
☐ الاعتماديات بين الأجهزة معروفة.
☐ المواقع والفروع مصنفة.
Availability:
☐ حالة الأجهزة مراقبة.
☐ الخدمات المهمة مراقبة.
☐ فقد لحظي لا يولد حادثًا غير ضروري.
Interfaces:
☐ Uplinks مراقبة.
☐ روابط الإنترنت مراقبة.
☐ منافذ الخوادم المهمة مراقبة.
☐ Errors وDiscards تحت المراقبة.
Performance:
☐ استخدام الروابط مرسوم تاريخيًا.
☐ Latency مراقب.
☐ Packet Loss مراقب.
☐ CPU والذاكرة مراقبان عند الحاجة.
SNMP:
☐ إعداداته مؤمنة.
☐ الوصول محدود للأجهزة المطلوبة.
☐ المقاييس المختارة مفيدة فعلًا.
Logs:
☐ Syslog مركزي.
☐ الوقت متزامن بين الأجهزة.
☐ البحث بالسجلات سهل.
☐ سياسة الاحتفاظ معروفة.
Baseline:
☐ السلوك الطبيعي معروف.
☐ أوقات الذروة معروفة.
☐ الاتجاهات التاريخية متاحة.
Alerts:
☐ Critical محددة.
☐ Warning محددة.
☐ التنبيهات المتكررة غير المفيدة مخففة.
☐ Maintenance Windows معرفة.
Notifications:
☐ القناة مناسبة للخطورة.
☐ المسؤول معروف.
☐ التصعيد واضح.
☐ لا تصل كل التنبيهات لكل الأشخاص.
Dashboard:
☐ الأجهزة الحرجة واضحة.
☐ المواقع المتأثرة واضحة.
☐ الروابط الرئيسية واضحة.
☐ التنبيهات المفتوحة واضحة.
Incident Response:
☐ Triage معروف.
☐ Runbooks موجودة للأعطال المتكررة.
☐ الحوادث موثقة.
☐ Root Cause يراجع بعد الحوادث المهمة.
التحسين:
☐ أكثر التنبيهات تكرارًا تراجع دوريًا.
☐ Thresholds تحدث عند الحاجة.
☐ الأجهزة الجديدة تدخل المنصة.
☐ الأجهزة الملغاة تزال.
☐ التقارير تساعد على قرارات السعة والصيانة.
كيف تعمل منظومة المراقبة في سيناريوهات شركات مختلفة؟
شركة متعددة الفروع
تعرض Dashboard كل فرع وحالة رابط الاتصال والأجهزة الأساسية.
إذا انقطع رابط فرع، يعرف الفريق فورًا أن كل الأجهزة خلفه قد تظهر Offline بسبب نفس السبب، بدل التعامل معها كحوادث منفصلة.
مكتب يعتمد على تطبيقات سحابية
التركيز يكون على روابط الإنترنت، Latency، Packet Loss، وحالة الأجهزة التي تمر عبرها الحركة.
عند شكوى الموظفين من البطء يمكن مقارنة زمن الشكوى مع استخدام الرابط والتأخير بدل الاكتفاء باختبار سرعة لحظي.
مستودع يعمل بالأجهزة المحمولة
تتم مراقبة السويتشات ونقاط الوصول والروابط المهمة وحالة المناطق التشغيلية.
إذا توقفت مجموعة Access Points في منطقة واحدة، يمكن تحديد السويتش أو Uplink المشترك بينها بسرعة.
شركة لديها غرفة سيرفر وشبكة داخلية
يراقب الفريق Core وDistribution وUplinks والواجهات نحو الخوادم والإنترنت.
تساعد الرسوم التاريخية على معرفة ما إذا كان هناك ارتفاع متكرر في استهلاك أحد المسارات أو مورد من موارد الأجهزة.
شركة صغيرة بفريق تقنية محدود
لا تحتاج إلى لوحة معقدة بها آلاف العناصر.
يمكن البدء بعشرة أو عشرين عنصرًا مهمًا وتنبيهات قليلة عالية القيمة، ثم التوسع لاحقًا.
منشأة تعمل على مدار ساعات طويلة
هنا تصبح عملية التصعيد مهمة لأن الحادث قد يحدث خارج وقت حضور المسؤول الرئيسي.
يجب تحديد من يستقبل التنبيه ومتى يتصاعد ومن يتواصل مع المزود الخارجي عند الحاجة.
| البيئة | الأولوية | أهم بيانات المراقبة | الفائدة |
|---|---|---|---|
| فروع متعددة | روابط المواقع | Availability / Latency | تحديد الفرع المتأثر |
| مكتب | الإنترنت والسويتشات | Bandwidth / Errors | تحليل البطء |
| مستودع | APs وUplinks | Status / Clients / Interfaces | عزل منطقة العطل |
| بيئة حرجة | الكشف والتصعيد | Alerts / Logs / Dependencies | استجابة أسرع |
ما أكثر الأسئلة الشائعة عن Network Monitoring للشركات؟
1. هل تحتاج الشركة الصغيرة إلى Network Monitoring؟
نعم إذا كان توقف الشبكة يؤثر على العمل، لكن يمكن أن تبدأ بمنظومة بسيطة تراقب العناصر الحرجة بدل نظام كبير ومعقد.
2. هل Ping كافٍ لمراقبة الشبكة؟
لا. Ping مفيد للتحقق من إمكانية الوصول، لكنه لا يكشف وحده استخدام الروابط أو أخطاء الواجهات أو الموارد أو السجلات.
3. ما أهم الأجهزة التي أبدأ بها؟
ابدأ بالراوترات والسويتشات الأساسية وروابط الإنترنت وربط الفروع والأجهزة التي يؤدي توقفها إلى أثر واسع.
4. هل يجب مراقبة كل Port في السويتش؟
يمكن جمع بيانات كثيرة، لكن التنبيه المباشر يجب أن يركز على المنافذ المهمة مثل Uplinks والخوادم ونقاط الوصول والمعدات الحرجة.
5. ما الفرق بين Monitoring وLogging؟
Monitoring يركز على الحالة والمقاييس والاتجاهات، بينما Logs تسجل أحداثًا تفصيلية حدثت داخل الأجهزة والأنظمة. استخدامهما معًا يعطي صورة أفضل.
6. ما فائدة Syslog؟
يجمع رسائل الأحداث من الأجهزة مثل تغير الواجهات أو بعض التغييرات والأخطاء، ويساعد على معرفة ما حدث في وقت المشكلة.
7. ما فائدة SNMP؟
يتيح جمع مؤشرات تشغيلية من أجهزة الشبكة مثل الواجهات والاستخدام والأخطاء والموارد عندما تدعم الأجهزة ذلك.
8. لماذا تصلنا تنبيهات كثيرة جدًا؟
غالبًا لأن Thresholds حساسة أكثر من اللازم أو لا توجد Dependencies أو أن كل حدث يعتبر Critical. يجب مراجعة القواعد بناءً على قيمة كل تنبيه.
9. ما هو Alert Fatigue؟
هو إرهاق الفريق من كثرة الإنذارات غير المهمة لدرجة أن التنبيهات الحقيقية قد يتم تجاهلها.
10. هل التنبيه عند CPU مرتفع كافٍ؟
الأفضل أن تأخذ مدة الارتفاع وسلوك الجهاز المعتاد في الاعتبار بدل التنبيه على كل قفزة قصيرة.
11. ما هي Dashboard الجيدة؟
لوحة تعرض حالة الشبكة والأجهزة الحرجة والتنبيهات المفتوحة والروابط المهمة بطريقة يمكن فهمها بسرعة دون ازدحام غير مفيد.
12. هل أحتاج شاشة NOC كبيرة؟
ليس بالضرورة. الأهم وجود لوحة واضحة وإجراءات استجابة. الشاشة الكبيرة مفيدة لبعض البيئات لكنها ليست شرطًا لنظام مراقبة ناجح.
13. هل يمكن إرسال التنبيهات إلى واتساب؟
يعتمد ذلك على أدوات الربط وطريقة التشغيل المعتمدة، لكن المهم هو اختيار قناة موثوقة وتحديد من يستقبل أي نوع من التنبيهات.
14. ما هو Baseline؟
هو فهم السلوك الطبيعي للشبكة خلال الأوقات المختلفة حتى يمكن تمييز الانحراف الحقيقي عن التغير الطبيعي.
15. كيف أعرف أن الرابط يحتاج توسعة؟
راقب الاتجاه التاريخي وساعات الذروة والاستمرار في الاقتراب من السعة بدل الاعتماد على قراءة لحظية واحدة.
16. هل Network Monitoring بديل عن مهندس الشبكات؟
لا. الأداة تجمع البيانات وتكشف الأحداث، لكن تحليل السبب واتخاذ القرار وتنفيذ الإصلاح يحتاج إلى عملية تشغيل وخبرة فنية.
17. هل Monitoring هو نفسه SIEM؟
لا. هناك تداخل في بعض البيانات، لكن Network Monitoring يركز غالبًا على تشغيل وأداء الشبكة، بينما SIEM يركز بصورة أوسع على تحليل الأحداث الأمنية وربطها.
18. هل يجب الاحتفاظ بالسجلات إلى الأبد؟
لا. يجب تحديد سياسة احتفاظ تناسب الحاجة التشغيلية والأمنية وحجم البيانات ومتطلبات الجهة بدل الاحتفاظ بلا هدف.
19. لماذا يجب توثيق الحادث بعد عودة الخدمة؟
لأن التوثيق يكشف سبب المشكلة، جودة التنبيه، الإجراءات التي نجحت، وما يجب تحسينه لمنع التكرار أو تقليل زمن الاستجابة لاحقًا.
20. ما المعلومات المطلوبة لبدء مشروع مراقبة شبكة؟
مخطط الشبكة، قائمة الأجهزة، المواقع، عناوين الإدارة، الروابط الرئيسية، الأجهزة الحرجة، الخدمات المهمة، قنوات التنبيه، فريق الدعم، وأسلوب التصعيد عند الحوادث.
ما الخلاصة النهائية لبناء Network Monitoring للشركات؟
ابدأ بجرد واضح لكل الأجهزة والروابط المهمة.
صنف الأجهزة حسب أثر تعطلها على العمل.
لا تعتمد على Ping وحده.
راقب Availability والواجهات واستخدام الروابط والأخطاء والموارد التي تؤثر على التشغيل.
استخدم SNMP لجمع المقاييس المناسبة عندما تدعمه الأجهزة وتكون إعداداته مؤمنة.
اجمع Syslog والسجلات المهمة في مكان مركزي يسهل البحث فيه.
ابنِ Baseline قبل تحديد كل Thresholds بشكل نهائي.
اجعل التنبيهات تعتمد على الأثر والمدة، لا على أي تغير لحظي.
صنف Alerts إلى مستويات واضحة مثل Critical وHigh وWarning.
استخدم Dependencies حتى لا يولد عطل واحد عشرات الحوادث الكاذبة.
راجع Alert Fatigue بصورة دورية وأوقف الإنذارات التي لا تقود إلى إجراء.
اجعل Dashboard تجيب عن سؤال: ما الذي يحتاج انتباهي الآن؟
أرسل التنبيه للشخص المناسب بدل إرساله للجميع.
أنشئ Escalation واضحًا للأحداث التي لا تتم معالجتها في الوقت المناسب.
عند وصول التنبيه، تحقق من صحته وحدد نطاق التأثير قبل تنفيذ أي إجراء.
راجع Logs وMetrics والتغيرات في نفس الفترة الزمنية للوصول إلى السبب.
لا تستخدم إعادة التشغيل العشوائي كأول خطوة في التحقيق.
وثق الحوادث المهمة ووقت اكتشافها ووقت استعادة الخدمة والسبب والإجراء.
استخدم البيانات التاريخية للتخطيط للسعة بدل انتظار الاختناق.
اربط المراقبة بأعمال الصيانة والتغييرات حتى تعرف أثر كل تعديل.
راجع إعدادات النظام باستمرار مع إضافة أجهزة جديدة وتغير استخدام الشبكة.
وفي بوابة المستقبل للشبكات يتم التعامل مع Network Monitoring كمنظومة تشغيل مستمرة تبدأ من جرد أجهزة الشبكة وفهم أهميتها واعتمادياتها، ثم مراقبة الحالة والأداء والواجهات والروابط والسجلات، وبعد ذلك بناء التنبيهات ولوحات المراقبة ومسارات التصعيد والاستجابة، بهدف اكتشاف الأعطال بشكل أسرع، تقليل التخمين أثناء التشخيص، وتوفير بيانات تاريخية تساعد الشركة على اتخاذ قرارات أفضل في الصيانة والتوسعة.
This post is part of a series called Post